
GenAI
プロダクト部門と運用部門向けのジェネレーティブAI
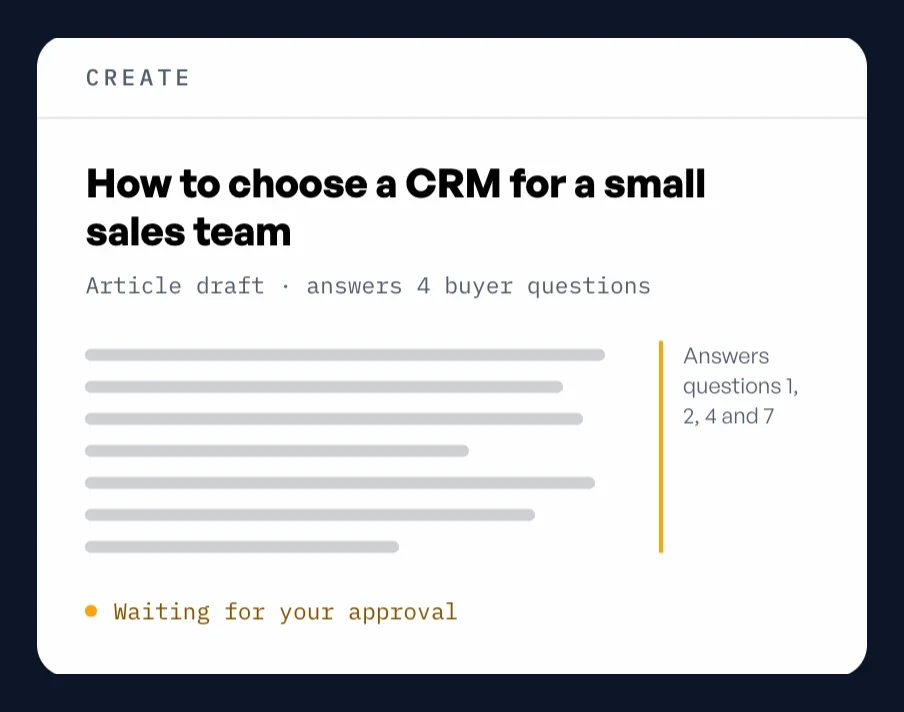
shyash.ai、自社プロダクト:AIエージェントが下書きを書き、配信前に担当者が承認します。
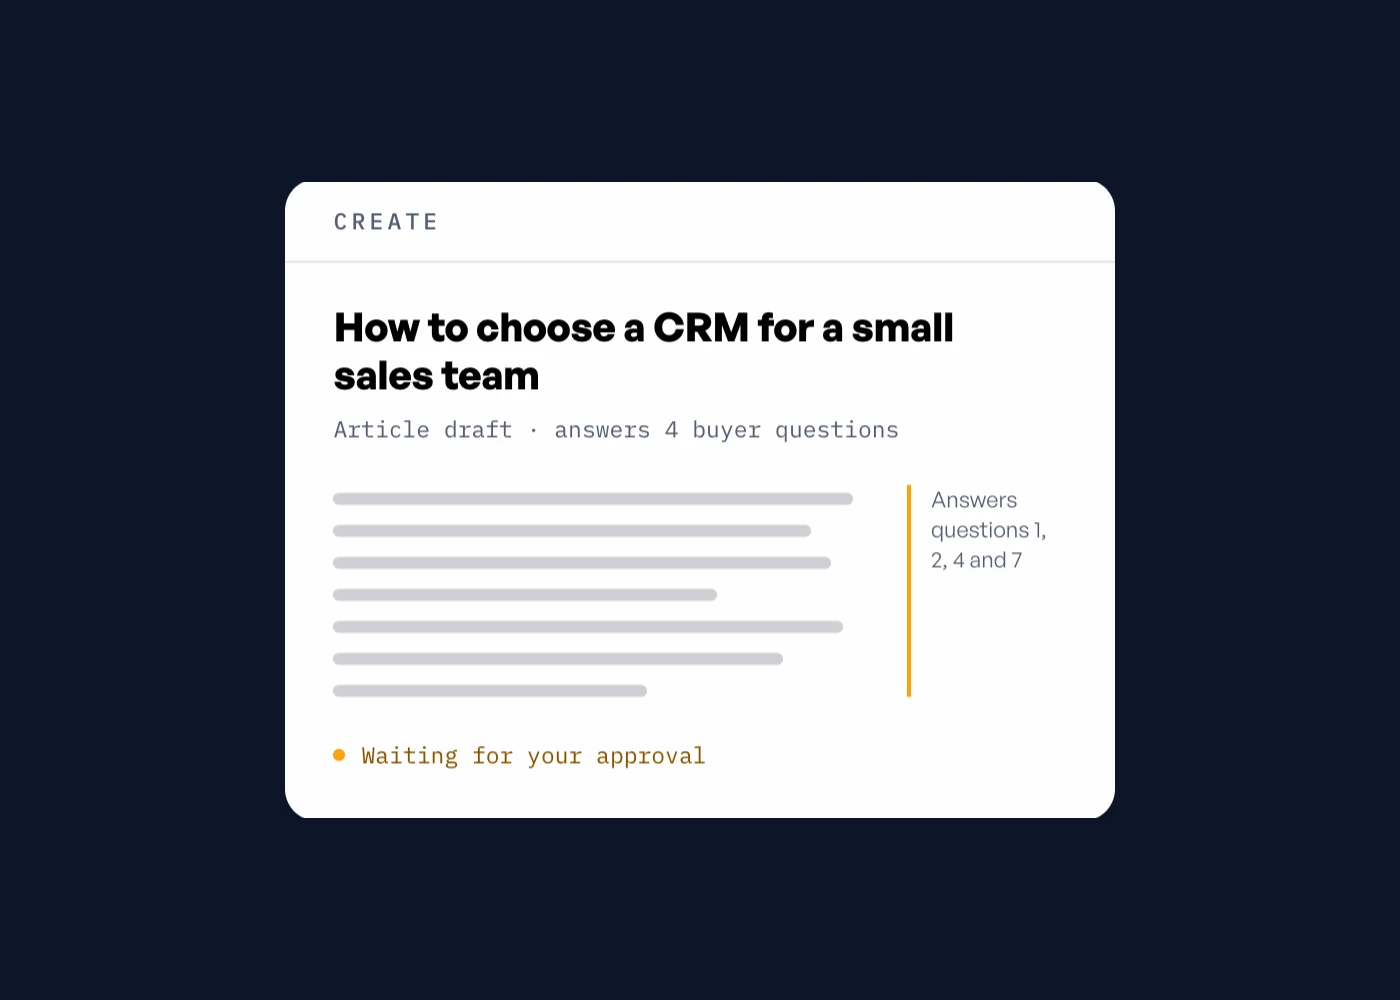
shyash.ai、自社プロダクト:AIエージェントが下書きを書き、配信前に担当者が承認します。
- 御社のチーム
- ご自身の文書から引き出した回答
- 御社のプロダクト
- 下書き、要約、検索を組み込み
- 稼働場所
- 自社のインフラ内のプライベートモデル
- 自社プロダクト
- shyash.ai:AIエージェント、担当者が承認
ジェネレーティブAIがチームにもたらすもの
自社のインフラ内
- 01御社の文書ポリシー、契約書、マニュアル、チケットを、いまある場所のまま扱います。
- 02検索インデックス質問に答える箇所を探し出します:検索拡張生成(RAG)。
- 03プライベート言語モデル管理下のサーバーで、それらの箇所から回答を書きます。
- 04御社のチームすでに使っているツールやシステムの中で回答が得られます。
- 01
チームへの回答を文書から作成し、プロダクトにはAI機能(下書き、要約、検索)を組み込みます。自社プロダクトのshyash.aiは、調査、執筆、確認、計測を行うAIエージェントで動き、配信されるものはすべて担当者が承認します。
チームが普通の言葉で質問すると、ポリシー、契約書、マニュアル、チケットから引き出した回答が返ります。仕組みは、御社の文書に対する検索拡張生成(RAG)です。
自社データに対するファインチューニングまたはRAG
- 02
文書をレコードに
私たちは、あるお客様のFinTechの境界の内側で、LLMインテグレーションを本番に導入しました。ブローカーと取引所からの非構造化の通知(コーポレートアクション、銘柄の変更、証拠金の変更)を抽出・正規化し、トレーディングシステムが取り込む構造化レコードにするものです。
AIによる文書処理
- 03
プロダクトに組み込む機能
下書き、要約、検索を、すでに運用しているプロダクトに組み込みます。プロダクトが自身のデータから返信やレポートの下書きを作り、長いファイルを要約し、普通の言葉での依頼からレコードを探します。
OpenAI APIかAnthropic APIか
- 04
プライベート言語モデル
自社のインフラ内にプライベート言語モデルを導入し、すでに稼働しているシステムに接続します。文書と顧客データは、御社の境界の内側に留まります。
OpenAI APIか、自社ホストのモデルか
- 05
止まったパイロット
デモでは動いたものの、本番に届かなかったパイロット。他のチームで止まったプロジェクトを引き継ぎ、データを社内に置く必要がある場合は御社のインフラ内で、本番稼働まで進めます。
本番に届かなかったAIパイロット
自社プロダクト · shyash.ai
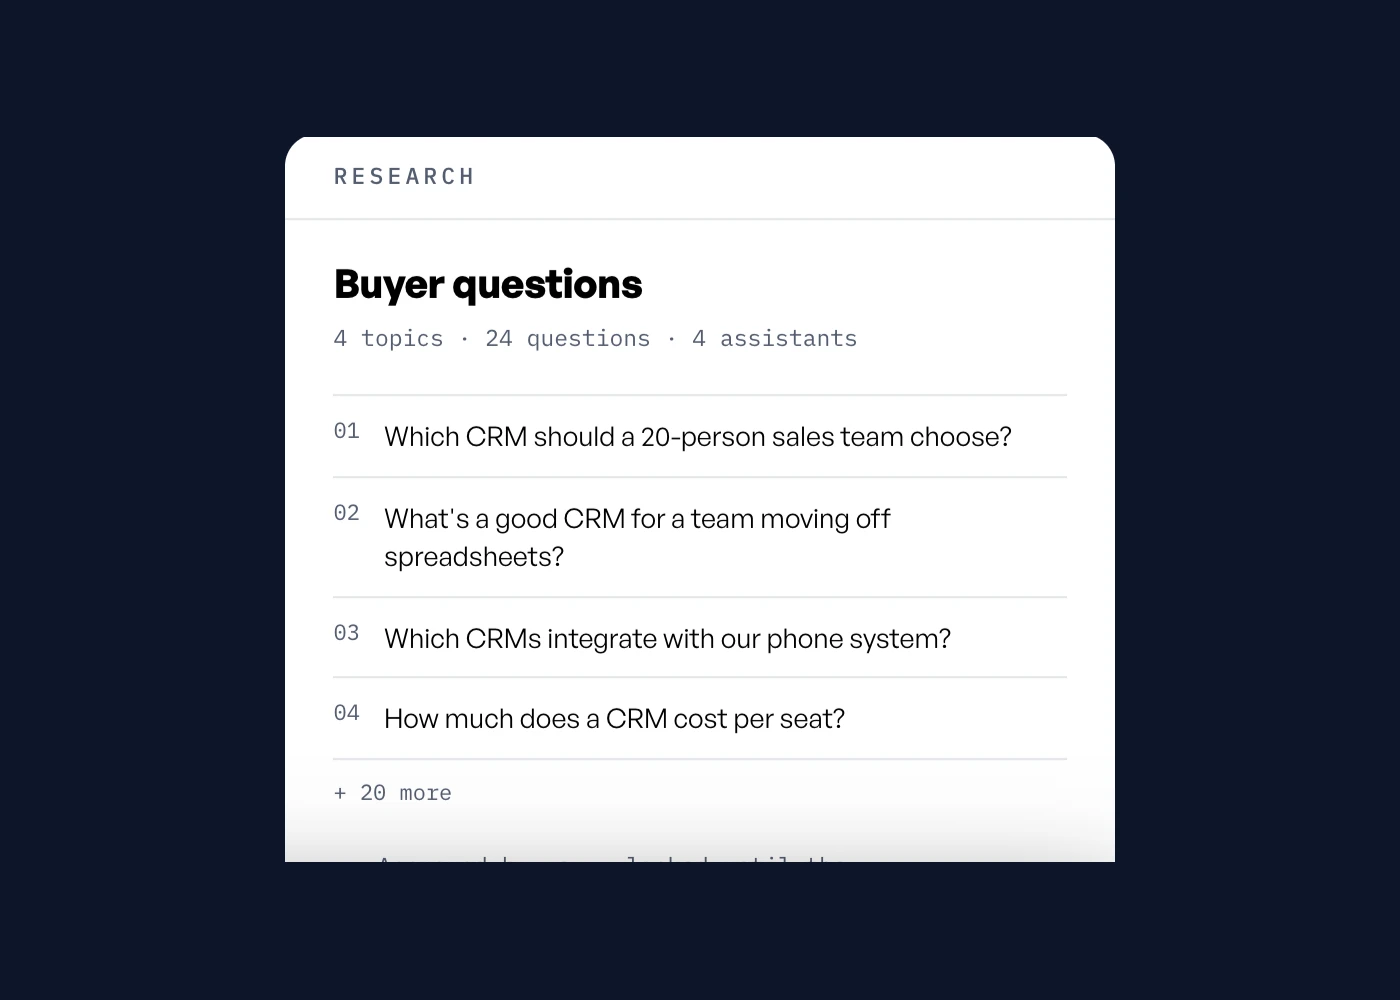
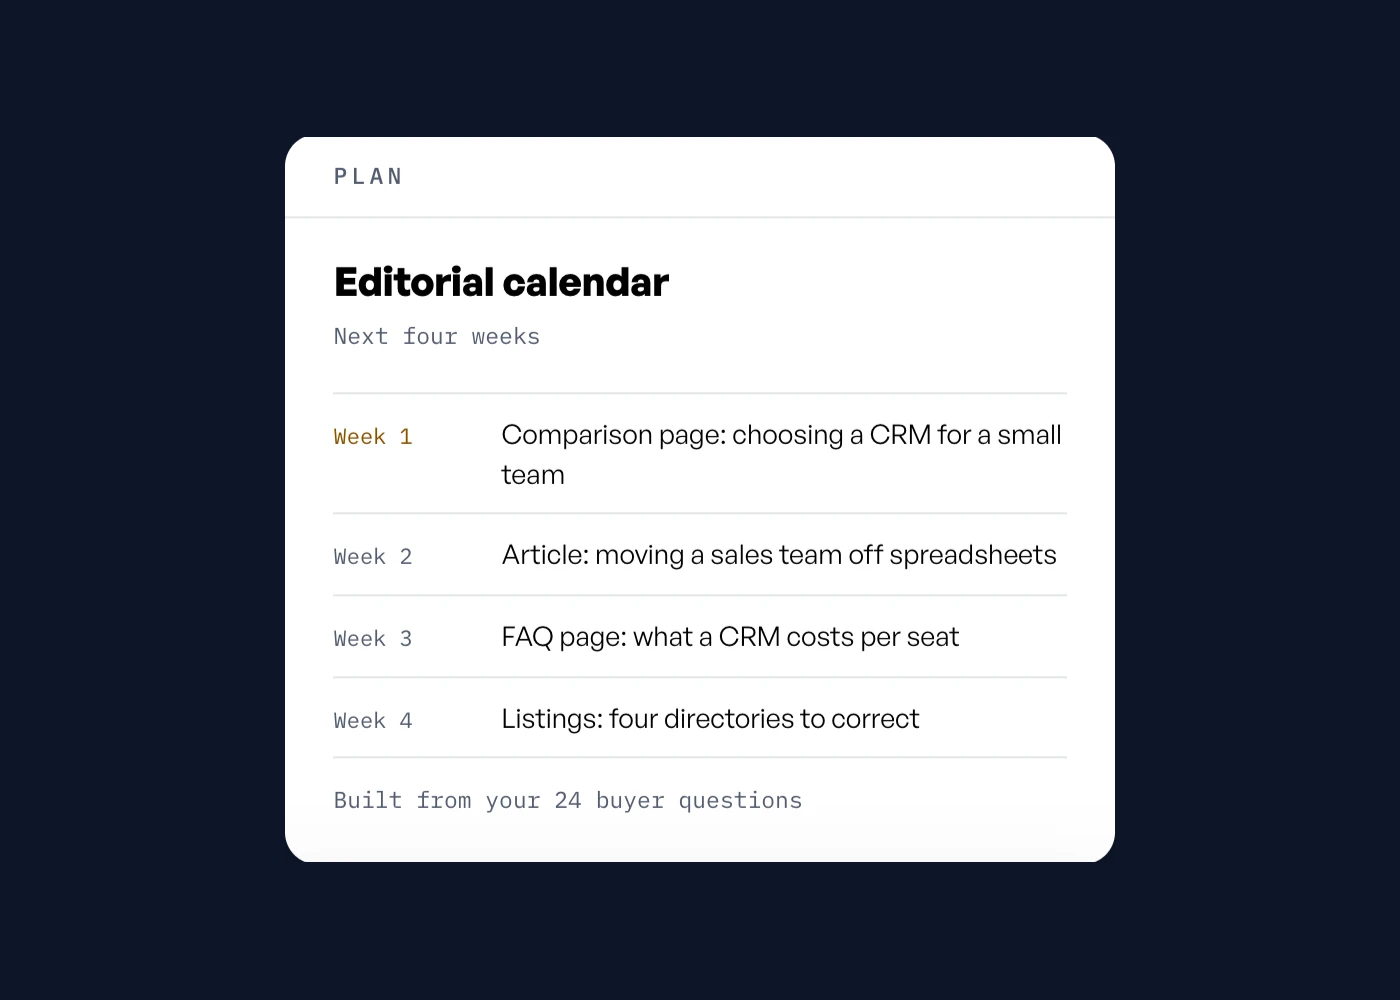
shyash.ai:AIエージェントが調査して書き、担当者が承認
- エージェント
- 調査、執筆、確認、計測を行います
- 記憶
- 会社の事実と決定事項を一つにまとめた共有ベース
- 管理
- 配信されるものはすべて担当者が承認します
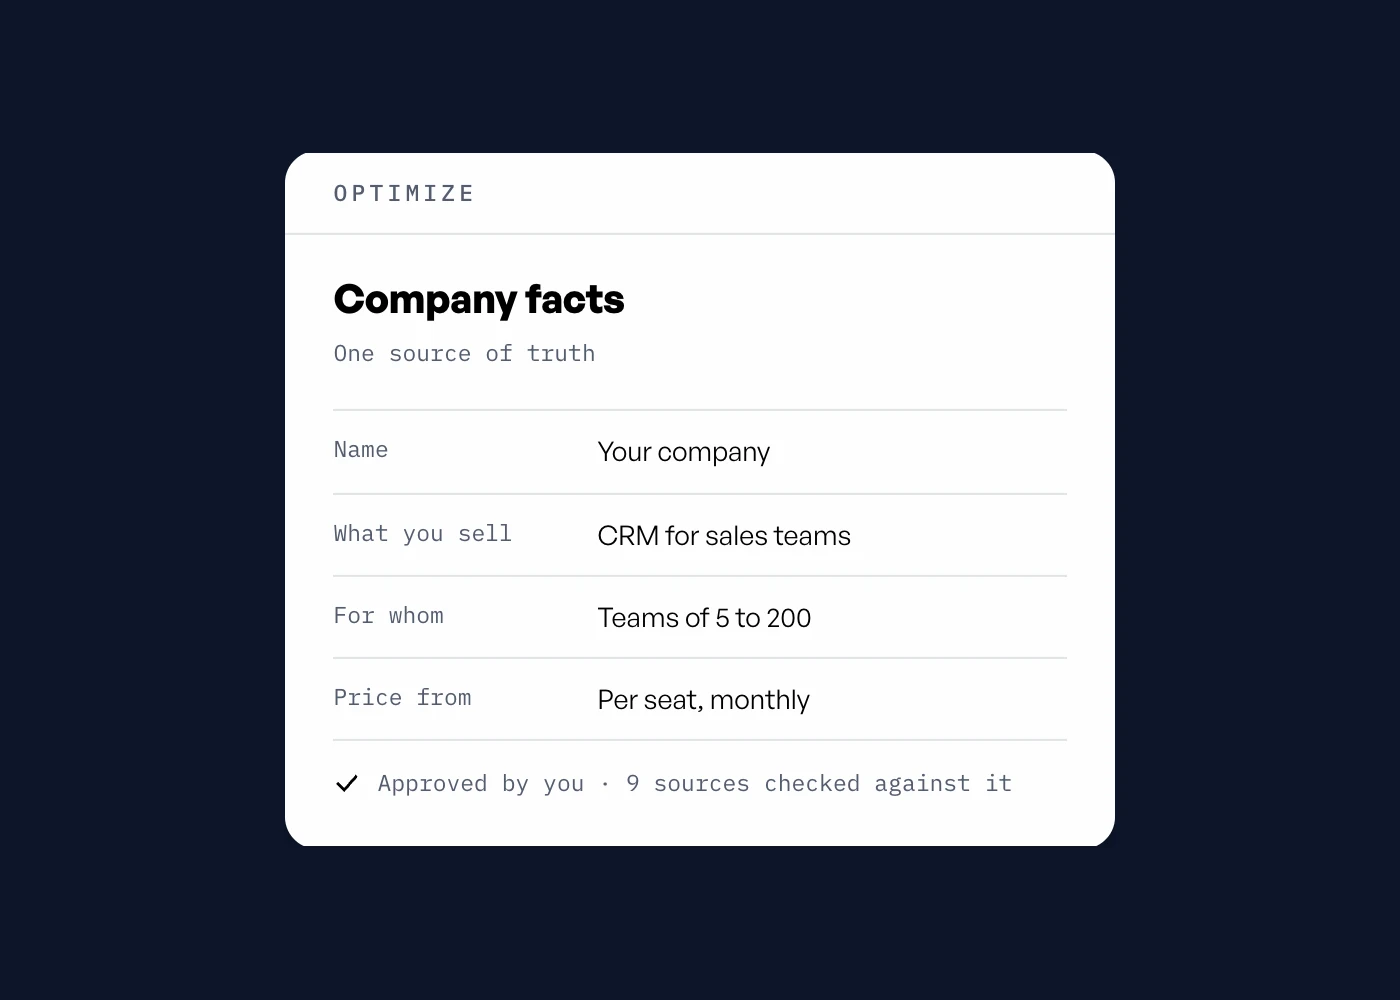
自社サーバーか、ホスト型APIか
プライベートモデルは自社のインフラ内で動き、文書もそこに留まります。OpenAIやAnthropicのホスト型APIは自社のサーバーが不要ですが、テキストは提供元に送られます。これらのページでは、両者のトレードオフと、プライベートモデルに必要なGPUメモリを整理しています。
次のステップ
AI機能や文書処理パイプラインを構築していますか?
文書、モデルを接続する必要のあるシステム、データを自社インフラの外に出してよいかどうかを数行でお送りください。
24時間以内に、明確な進行計画をお返しします。
3つの協業形態
- 1
フルデリバリー
アーキテクチャから構築、ローンチまで、プロジェクト全体を引き受けます。
- 2
専任チーム
御社のプロダクトだけに取り組み、必要な期間ご利用いただけるエンジニア。
- 3
チームに加わるエンジニア
当社のエンジニアが御社のチームに加わり、御社のプロセスと責任者のもとで作業します。
プロダクトとコードの所有権はすべてお客様にあります。ただし、当社の再利用可能なコンポーネントを除きます。
納品されたシステム、または合意した期間のチームに対してお支払いいただきます。プロダクトへのアクセスは販売していません。
開始の流れ
- 1
プロジェクトについてご記入ください
何を作っていて、どこで行き詰まっているかを数行でご記入ください。
- 2
無料のプロジェクト初回相談
プロジェクトとそのアーキテクチャについて話し合う30分のセッションです。
- 3
プロジェクトの料金
セッションの後、プロジェクトの作業内容を見積もります。
- 4
一緒に構築する
フルデリバリー、専任チーム、またはお客様のチームに入るエンジニア。
よくいただく質問
ジェネレーティブAIとは、何を指しますか?
指示から新しいテキスト、画像、コードを生成するモデル。ChatGPT、Claude、Geminiの基盤となる大規模言語モデルはテキストを扱い、質問への回答、下書きの作成、文書の要約、文書からの事実の抽出を行います。
ジェネレーティブAIは、運用部門に何ができますか?
価値の大半は、テキスト中心の作業にあります。社内文書に基づくスタッフの質問への回答、返信やレポートの下書き、長いファイルの要約、通知文書、フォーム、メールを自社システム向けの構造化レコードにすることです。
モデルは自社のインフラ内で動かせますか?
はい。自社のインフラ内にプライベート言語モデルを導入し、すでに稼働しているシステムに接続します。自社の文書に対する検索拡張生成(RAG)も構築します。
shyash.aiとは何で、誰が作りましたか?
shyash.aiは自社プロダクトで、AIアシスタントが購入者に何を伝えているかを企業に示します。調査、執筆、確認、計測を行うAIエージェントで動き、配信されるものはすべて担当者が承認します。
GenAIではどんな仕事を受けていますか?
社内文書に基づく回答、プロダクトに組み込むAI機能、文書からの構造化レコードを、自社インフラ内のプライベートモデルで提供します。自社プロダクトのshyash.aiはAIエージェントで動き、配信されるものはすべて担当者が承認します。
構築の前にお読みください
最近の記事
読了9分
生成AIを自社サーバーで:プライベートな言語モデルに必要な GPU メモリはどれくらいか
プライベートな言語モデルに必要な GPU メモリの見積もり方。重み、リクエストごとに増えるメモリ、それが何台の GPU を意味するか、そして1時間あたりのレンタル料金。
読了10分
ファインチューニングか RAG か:AI モデルを自社のデータで学習させるか、自社の文書を検索させるか
自社の文書をもとに質問に答えるには、AI モデルにはたいてい、質問ごとに事実を調べる RAG が必要だ。ファインチューニングは、形式と口調に向いている。
読了10分
ML チームなし:自社サーバー上でサポートチケットと文書を扱う LLM システムを、ローンチ後に誰が運用するのか
ML チームを持たない会社は、LLM システムの運用を、それを構築した会社に任せることができる。自社の IT チームが、仕事の一部またはすべてを引き継ぐこともできる。
読了10分
バックオフィスの文書業務を BPO 事業者に委託するか、自社サーバー上の AI で自動化するか:COO はどう決めるのか
保険金請求や KYC 書類は、BPO 事業者のスタッフに処理してもらうことも、自社サーバー上の AI に読ませることもできる。自社の文書の同じサンプルで、両方を採点する。